O teste de dois minutos que expõe o tamanho do problema
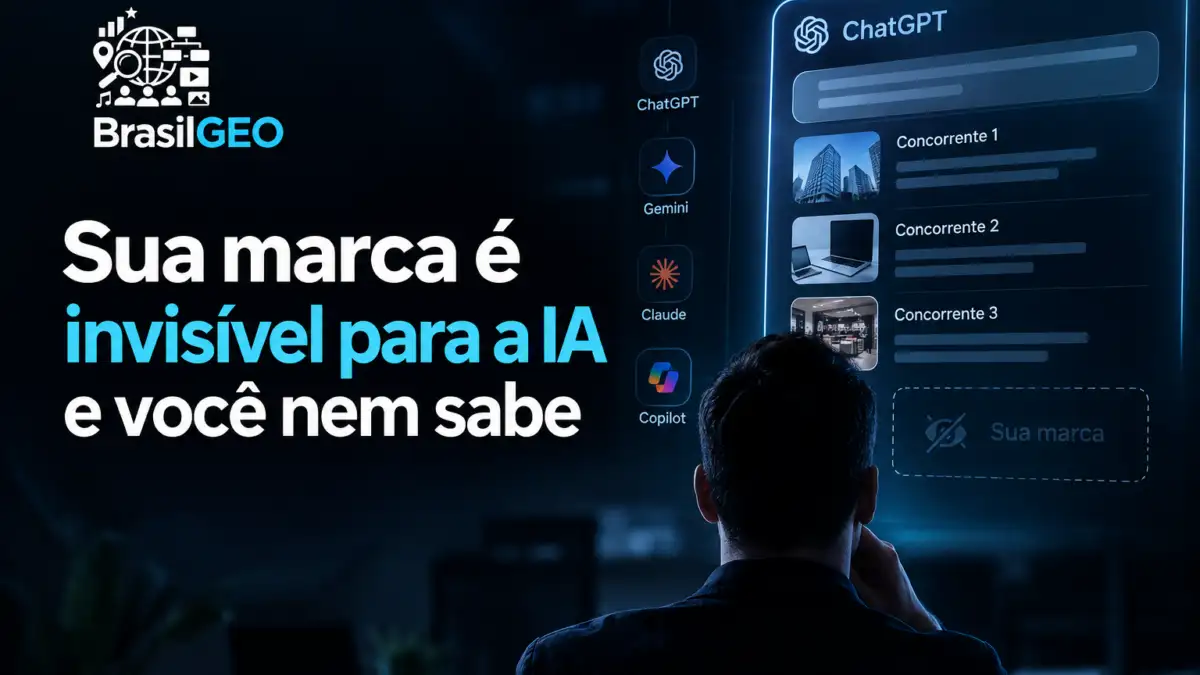
Abra o ChatGPT, o Gemini e o Claude agora. Em seguida, faça a pergunta que o seu comprador faria. Algo como quais são os principais fornecedores da sua categoria no Brasil. Depois, observe a lista devolvida.
Quando a marca fica de fora, existe um diagnóstico pronto. Ou seja, a empresa vive em estado de invisibilidade algorítmica.
O detalhe incômodo aparece no contraste com a reputação. Muitas empresas lideram o próprio mercado há anos. Além disso, elas investiram em SEO, conteúdo e eventos. Ainda assim, o modelo cita o concorrente.
A explicação envolve legibilidade. Generative Engine Optimization (GEO) trabalha exatamente essa camada, porque a máquina reconstrói a marca a cada pergunta.
Cinco sinais de que o modelo trocou você pelo concorrente
Os sintomas aparecem cedo. Portanto, vale conferir cada um antes de investir em produção de conteúdo.
- Confusão de entidade. O modelo mistura a sua marca com um homônimo ou com uma empresa de nome parecido. Esse comportamento recebe o nome de entity drift.
- Descrição genérica. A IA reconhece o nome e devolve uma definição vaga, que serve a qualquer concorrente. Inclusive, muitas descrições carregam dados de dois anos atrás.
- Concorrente no seu lugar. A pergunta cobre a categoria e a resposta lista quatro fornecedores. Enquanto isso, a sua marca fica fora da lista curta.
- Dado de contato errado. O modelo cita a marca e aponta URL antiga, filial incorreta ou endereço inexistente. Logo, a confiança algorítmica cai.
- Ausência declarada. O modelo informa que faltam informações sobre a empresa. Esse cenário parece grave, e também costuma ser o mais rápido de corrigir.
A frequência desses sinais varia por porte. Coletas de 2026 mostram marcas globais presentes em cerca de 73% das respostas medidas. A média fica perto de 44%. Já a marca de nicho fica em torno de 11%.
Anatomia da invisibilidade: quatro camadas que falham juntas
O modelo precisa de quatro elementos para incluir uma marca na resposta. Primeiro, uma entidade clara, sem ambiguidade de nome. Depois, dados estruturados com Schema.org, Wikidata e sameAs. Em seguida, conteúdo citável, com atribuição explícita. Por fim, consistência entre todas as fontes públicas.
Quando um desses elementos falha, o modelo hesita. Assim, ele cita quem apresenta sinal mais robusto.
Nos diagnósticos da Brasil GEO, a maioria das empresas falha em pelo menos três camadas ao mesmo tempo. Porém, o efeito da correção se acumula. A entidade dá sentido à estrutura. A estrutura dá contexto ao conteúdo. Então o conteúdo consistente transforma a marca em fonte confiável.
Robots.txt: o bloqueio silencioso que anula todo o resto
A camada técnica vem antes de qualquer estratégia editorial. Um site com conteúdo excelente fica invisível quando o agente de IA recebe bloqueio na porta de entrada.
O ponto crítico envolve especificidade. Cada agente lê o arquivo com regras próprias. Portanto, teste agente por agente, com checagem do status de resposta.
| Agente | Função principal | Efeito do bloqueio |
|---|---|---|
| GPTBot | Coleta para treinamento da OpenAI | A marca perde presença no conhecimento do modelo |
| ClaudeBot | Coleta da Anthropic para os modelos Claude | A citação em Claude fica comprometida |
| PerplexityBot | Recuperação em tempo real do Perplexity | A resposta com fonte deixa de citar o domínio |
| CCBot | Common Crawl, base usada por vários modelos | O alcance indireto em diversos sistemas cai |
Levantamento do Cloudflare Radar em junho de 2026 registrou GPTBot bloqueado em 712 domínios e ClaudeBot em 623. Parte dessas decisões nasce de política editorial declarada. Contudo, muitos bloqueios surgem de plugin de SEO, firewall ou regra antiga sem revisão.
A checagem cabe em dez minutos. Primeiro, abra o robots.txt do domínio. Depois, procure diretivas Disallow associadas a esses agentes. Em seguida, confirme no log do servidor quais bots realmente acessam o site.
Auditoria em uma tarde, sem ferramenta paga
O diagnóstico responde três perguntas objetivas. A IA sabe que a marca existe? Ela descreve a marca com precisão? Ela cita a marca quando o assunto é a categoria?
O roteiro segue cinco passos:
- Monte o banco de perguntas. Liste de cinco a dez perguntas reais do comprador, com uma de categoria, uma de marca e uma de comparação direta.
- Rode em quatro motores. Use ChatGPT, Gemini, Claude e Perplexity. Depois, registre presença, precisão da descrição e concorrentes citados.
- Meça a base técnica. Verifique robots.txt, llms.txt, dados estruturados em JSON LD, hierarquia de títulos e dependência de JavaScript para renderizar texto.
- Audite a entidade. Compare nome, descrição, URLs e contatos entre site, LinkedIn, Crunchbase, Google Business Profile e Wikidata. Cada divergência vira item de correção.
- Consolide e repita. Reúna tudo em um documento, com responsável e prazo. Então repita o mesmo teste a cada 30 dias.
Um cuidado metodológico evita ruído. Modelos variam a resposta entre execuções. Por isso, rode cada pergunta de cinco a dez vezes antes de concluir qualquer coisa.
Plano de dez dias úteis que reposiciona a entidade
A fundação técnica e semântica fica pronta em duas semanas de trabalho focado.
- Dias 1 e 2. Defina a descrição de referência: nome oficial, tagline, versão de 50 palavras e versão de 150 palavras. Depois, replique o mesmo texto em todas as plataformas.
- Dias 3 e 4. Implemente Schema.org com Organization, Person para executivos, WebSite e FAQPage. Além disso, preencha o campo sameAs com as URLs que confirmam a identidade.
- Dias 5 e 6. Publique o llms.txt na raiz do domínio, com descrição, produtos, temas de especialidade, links principais e contato.
- Dias 7 e 8. Produza três peças de alta citabilidade: um FAQ da categoria, um artigo com framework original e uma página institucional que funcione como fonte.
- Dias 9 e 10. Repita a auditoria inicial, com as mesmas perguntas e os mesmos motores. Assim, a evolução aparece em comparação direta.
Alexandre Caramaschi, founder da Brasil GEO, trata esse conjunto como pré requisito de elegibilidade. Em seguida, a frequência de citação passa a depender de consistência e de mídia conquistada.
O que muda depois, e em que ordem
Os resultados chegam em sequência previsível. Primeiro, a precisão da descrição melhora, porque o modelo encontra sinais coerentes. Depois, a marca começa a aparecer em perguntas de categoria. Por fim, a recomendação passa a acontecer no contexto certo, para o público certo.
O prazo varia conforme o tipo de modelo. Sistemas com navegação, como ChatGPT e Perplexity, refletem mudanças em duas a quatro semanas. Já modelos dependentes de treinamento levam de um a três meses.
A janela competitiva segue aberta por pouco tempo. A maior parte do mercado ainda ignora esse diagnóstico. Enquanto isso, quem se posiciona primeiro acumula citações e reforça a própria presença.
Se um comprador perguntasse agora sobre a sua categoria, qual concorrente apareceria no seu lugar?
Perguntas que o time leva para a reunião
Como saber se a minha marca está invisível para a IA?
Rode de cinco a dez perguntas do seu comprador em quatro motores. Depois, registre presença, precisão da descrição e concorrentes citados.
Bloqueio no robots.txt derruba mesmo a citação?
Sim, quando o agente recebe Disallow. Portanto, confira agente por agente e confirme o acesso pelos logs do servidor.
Preciso de ferramenta paga para começar?
As correções de base funcionam com acesso direto às plataformas. Já a escala e o monitoramento contínuo pedem automação.
Quanto tempo leva para sair da invisibilidade?
A fundação fica pronta em dez dias úteis. Em seguida, os primeiros sinais aparecem entre duas e quatro semanas nos modelos com navegação.
Ranquear bem no Google resolve?
O bom desempenho em busca ajuda no rastreamento. Além disso, a citação em IA depende de entidade clara, dados estruturados e fontes externas consistentes.